为什么一个密码,最后变成了两个验证码?
登录一个稍微重要些的系统,流程通常是这样的:输入用户名、密码,眼看就要进去了,页面又弹出一句“请输入验证码”。
验证码可能来自短信或身份验证器。登录公司的 VPN、邮箱、堡垒机时,有时还得拿出手机,再点一次确认。
不少人会觉得奇怪:密码明明输对了,为什么还要验证?如果密码已经能证明“我是我”,后面这一步究竟在防谁?
答案要从几十年前说起。今天随处可见的多因子认证(MFA),并不是从一开始就规划好的完整方案。它更像一连串安全事故留下的结果:人们逐渐发现,单凭密码,系统其实很难确定屏幕前的人是谁。
一、密码最初要解决的不是黑客问题
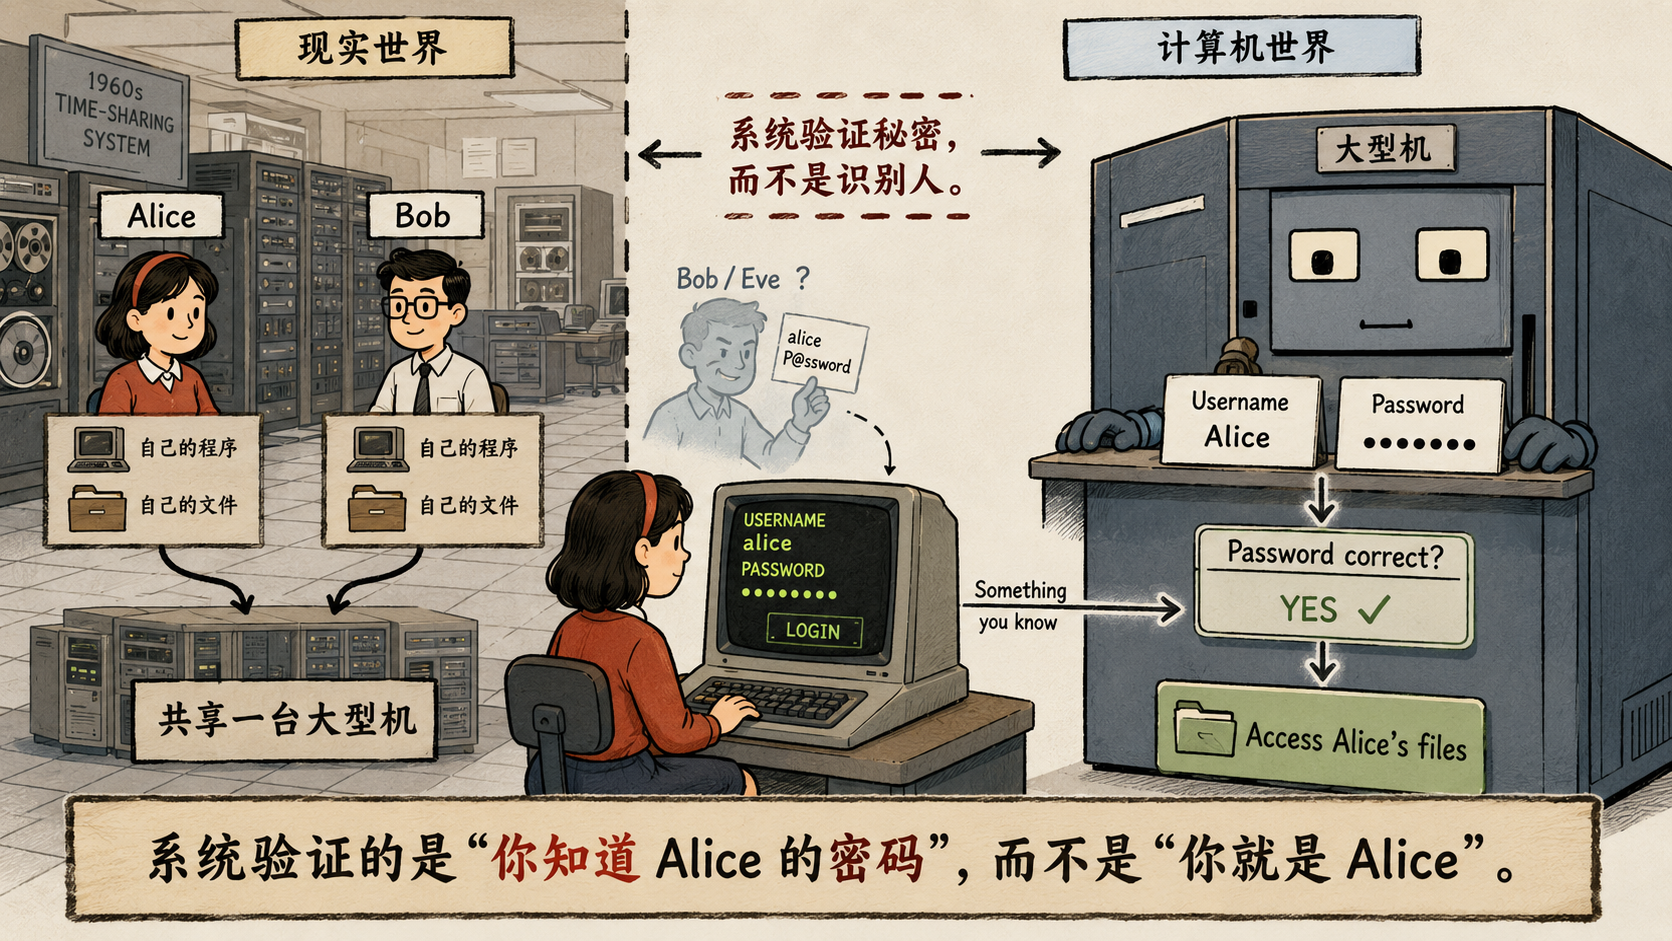
先回到计算机昂贵而稀少的年代。一台大型计算机往往由许多人共同使用,每个人都有自己的程序和文件。系统需要分清,当前坐在终端前的是 Alice 还是 Bob。
20 世纪 60 年代,MIT 的 CTSS 分时系统已经用密码登录,并按用户身份保护文件。密码认证的历史,比今天意义上的互联网还早。
它的设计很直白:
用户名 + 密码
用户名说明“你声称自己是谁”,密码则用来检查“你是否知道那个只有本人应该知道的秘密”。电脑登录密码、银行卡 PIN 和网站密码,都属于同一类认证因子:Something you know,也就是“你知道的东西”。
在相对封闭的环境中,这套办法简单、便宜,也确实好用。不过它从一开始就有一个缺口:计算机并没有认出 Alice,只能确认有人输入了 Alice 的密码。
这两件事看似接近,实际上差得很远。
二、密码上网以后,开始在路上被人看见
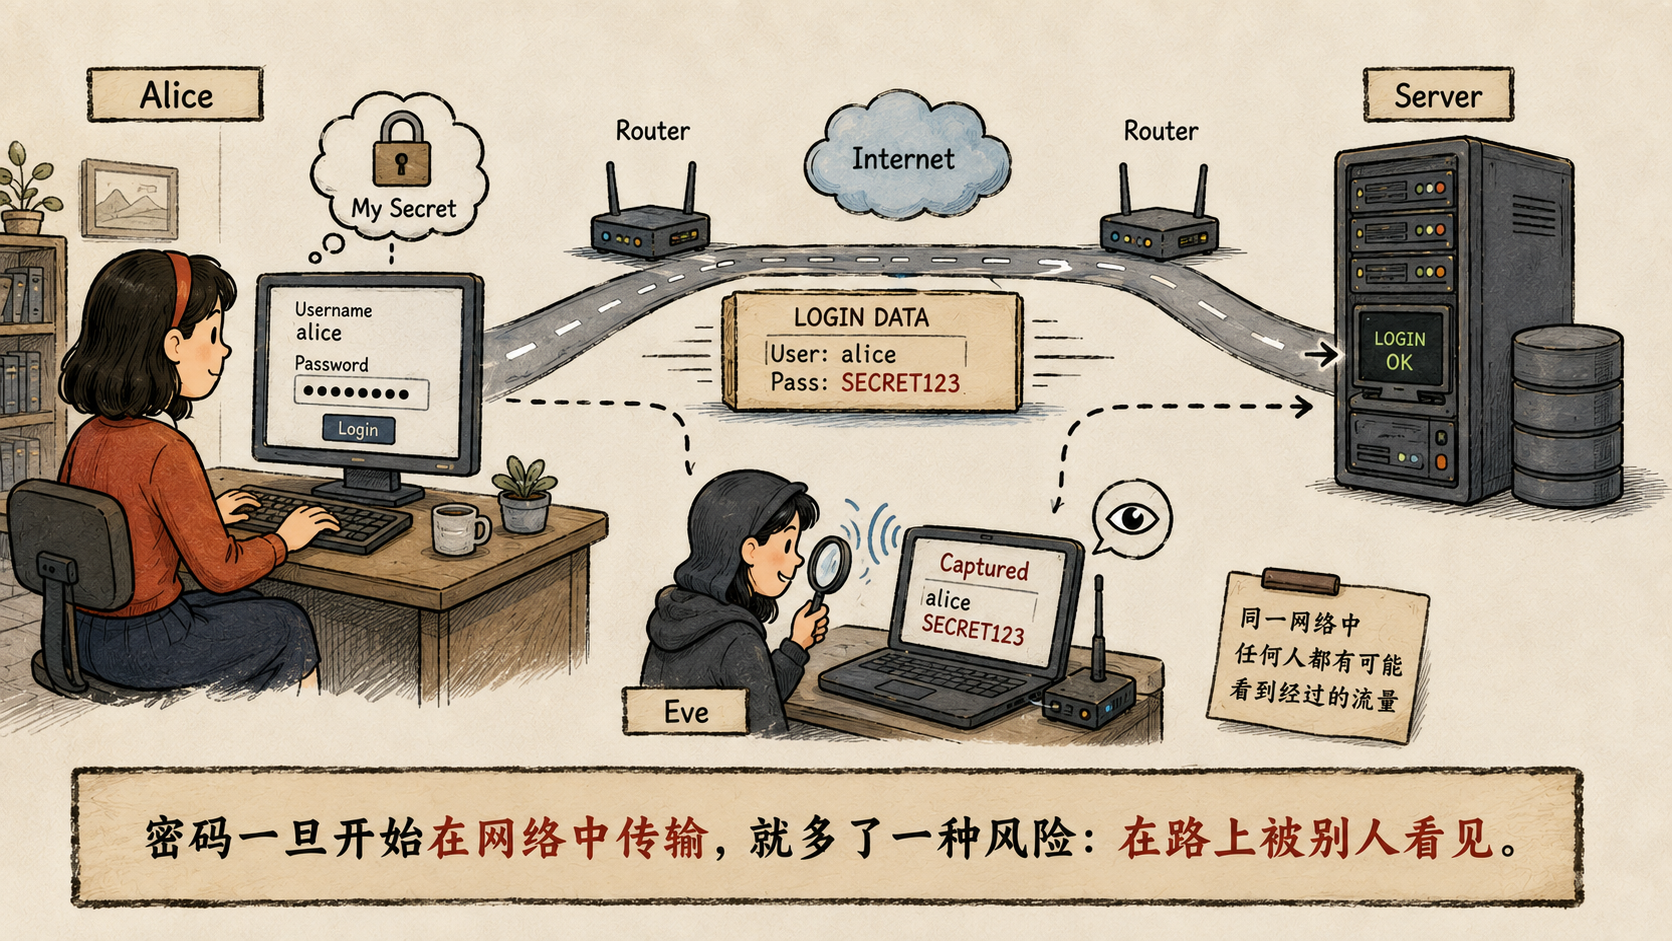
计算机联网后,登录不再只发生在本机。Alice 可以通过网络连接远程计算机:
Alice → 网络 → 远程计算机
最省事的做法,自然是把已有的用户名和密码机制直接搬到网络上。早期网络规模小,参与者也相对可信,许多协议首先考虑的是“能不能用”,而不是如何应对监听和攻击。
FTP 就是典型例子。它早期的登录流程非常直接:
USER <username>
PASS <password>
用户名和密码以明文传输。后来 IETF 讨论 FTP 的安全扩展时也明确指出,只要能监听链路,就能读到这些认证信息。换句话说,密码并非遭到某种复杂破解后才泄露;协议原本就让沿途的人有机会看见它。
随着 ARPANET 扩展、局域网互联,不同组织的网络被路由器接到一起,原先相对可控的环境变成了可被观察的传输路径。攻击者不必接触 Alice,也不必攻入服务器,只要能监听中间链路,就可能拿到完整凭据:
Alice ── Password ──→ Server
             └─────→ Eve(监听者)
Eve 得到的不是猜测结果,而是一份可以照抄的密码。下次她用同样的用户名和密码登录,系统仍会把她当成 Alice。
人们意识到这个问题后,并没有马上抛弃密码,而是先想办法把它保护起来:给传输加密,使用挑战应答避免直接发送密码,或者交给集中的认证服务器验证。SSL/TLS 和后来的各种网络认证协议,都沿着这些方向发展。
FTP、Telnet 和早期 HTTP Basic Auth(Base64 编码不是加密)则提醒了人们:认证安全不仅取决于密码本身,也取决于密码经过什么网络、以什么形式传输。
密码从此不再只是用户脑中的秘密,也是一段会在系统之间流动、可能被复制、记录和重放的数据。
三、把传输保护起来,还是不够
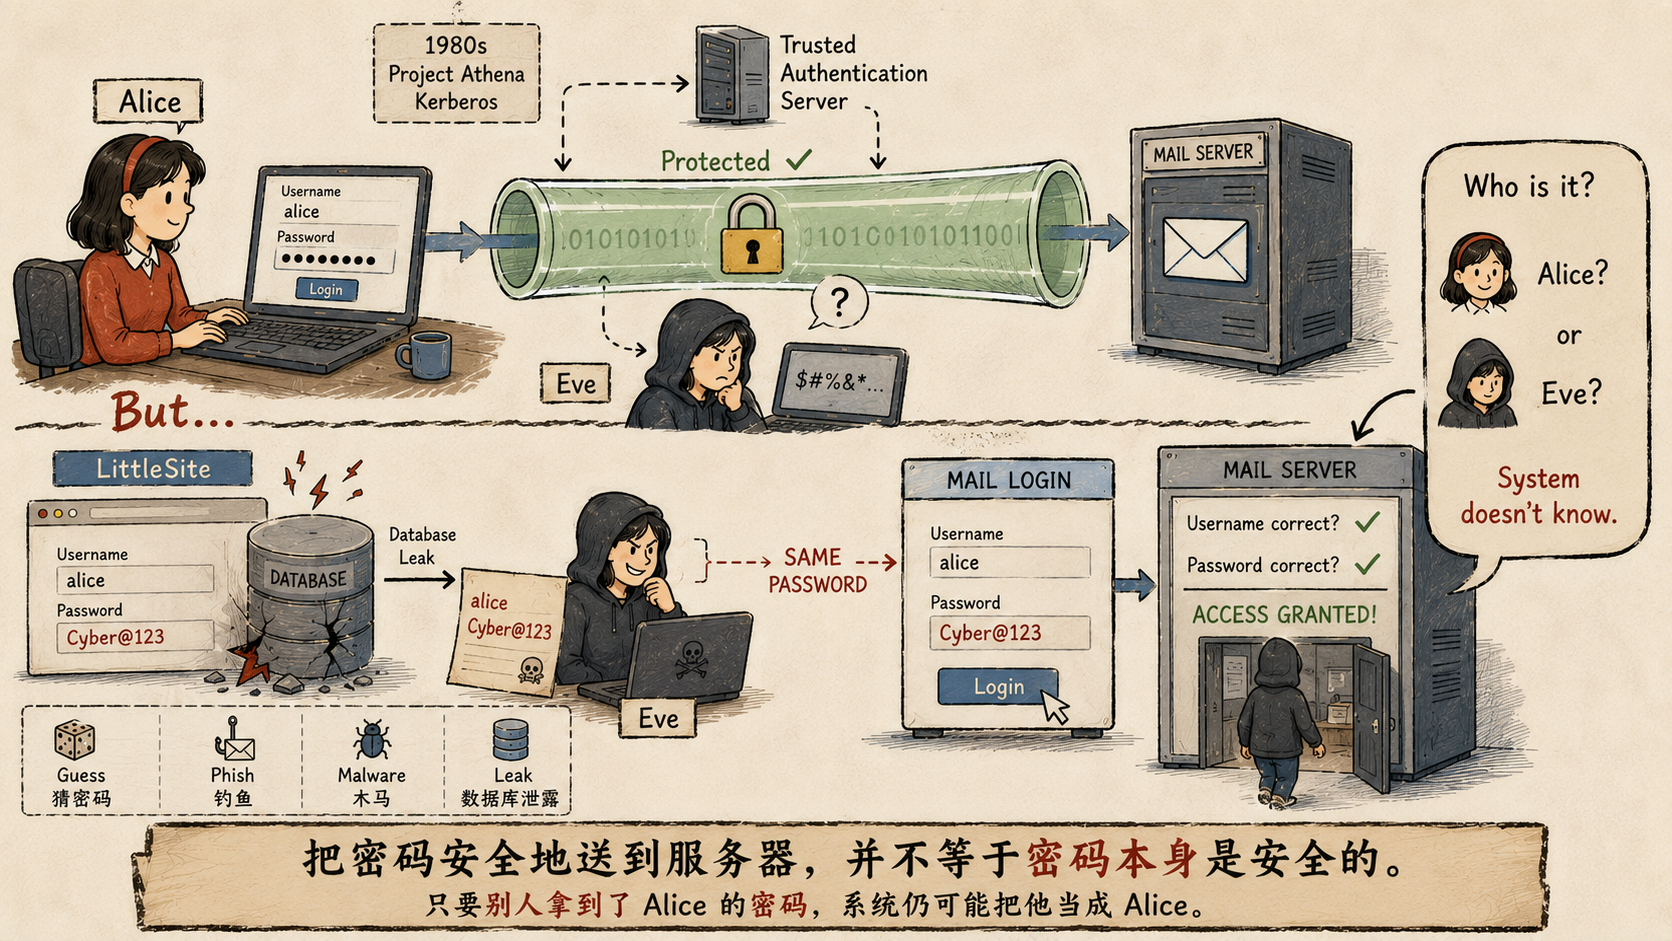
到了 20 世纪 80 年代,MIT 的 Project Athena 在设计 Kerberos 时,面对的正是开放网络中的身份认证问题:工作站本身未必可信,客户端和服务器需要借助可信的第三方认证服务来确认身份。
这类设计大幅降低了密码直接暴露在网络中的风险,也让人们开始同时考虑认证发生的环境。不过,攻击者并不一定非要在网络链路上偷密码。
密码还可能被猜中、被钓鱼网站骗走、被木马记录,或者随数据库泄露。密码复用又把问题放大了一层:如果十个网站共用一个密码,攻击者只需攻破其中防护最弱的那个,再拿泄露的凭据去尝试邮箱、社交账号或公司 VPN。
假设邮箱和某个小网站都使用:
Cyber@123
小网站泄露后,攻击者拿它去登录邮箱。系统看到的仍然是“用户名正确,密码正确”,于是照常放行。它无法判断来人究竟是 Alice,还是一个碰巧拿到了 Alice 密码的人。
问题到这里已经变了。过去大家关心的是怎样安全地传输密码,现在不得不追问:密码这种凭据本身,究竟能不能承担全部信任?
四、更复杂的密码,解决不了“被复制”
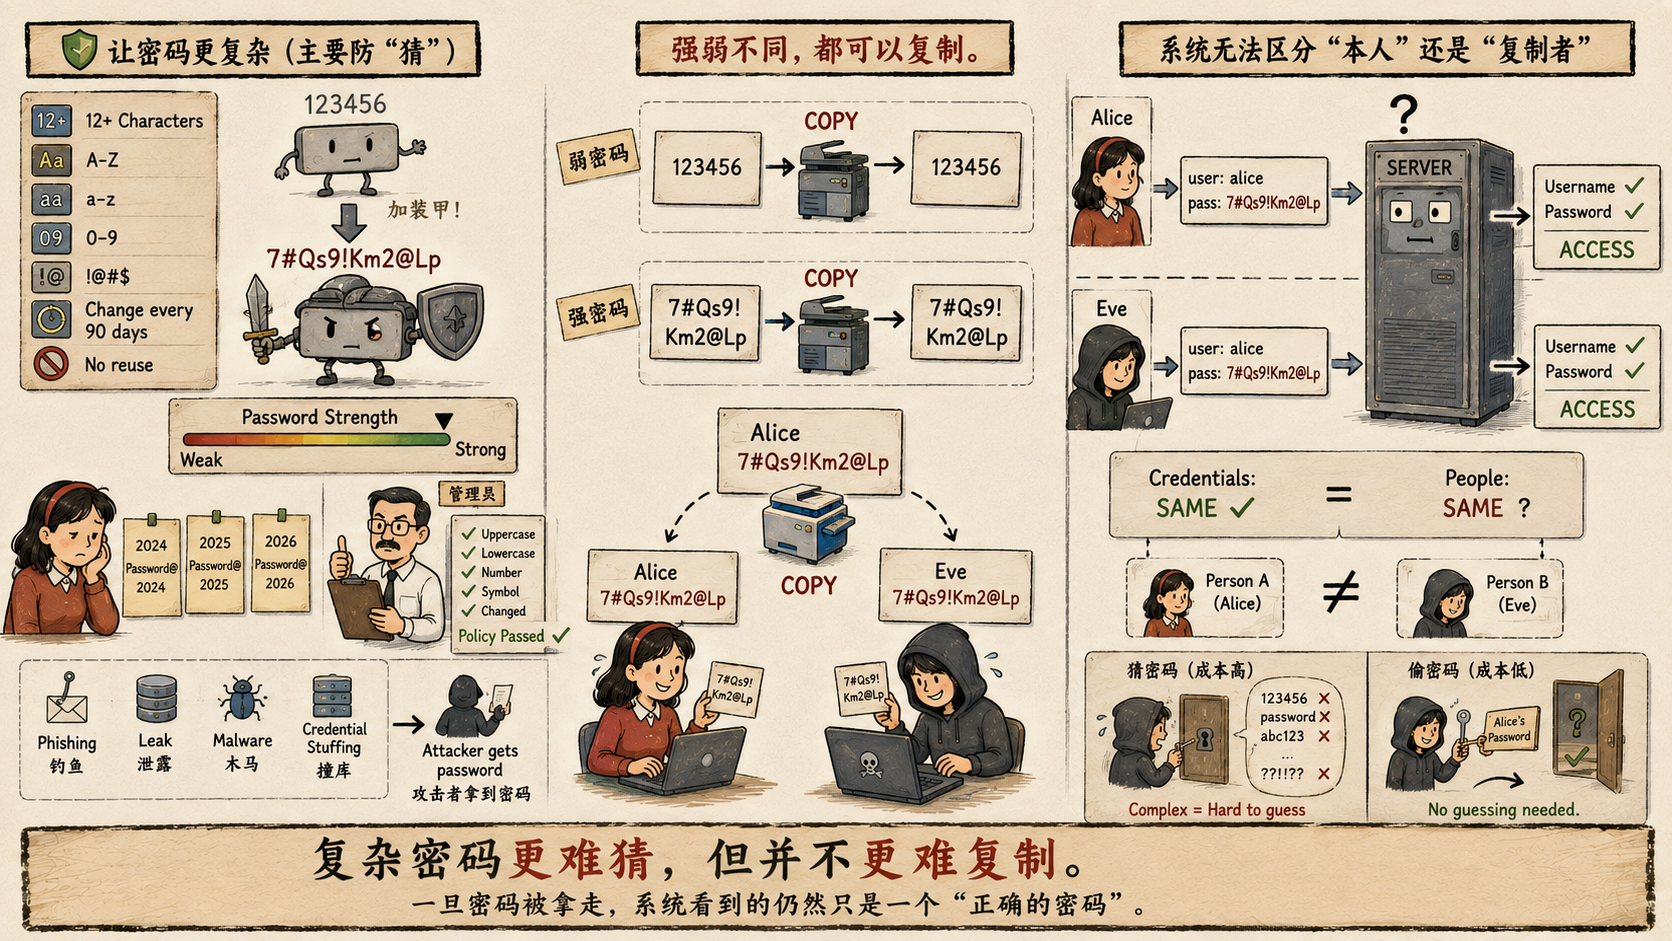
为了对付猜测和暴力破解,系统开始要求更长、更复杂的密码:大小写字母、数字、特殊字符缺一不可,还要定期更换,不能和旧密码重复。
用户也很快学会了应付:
Password@2024
Password@2025
Password@2026
系统认为规则更严格了,用户记密码越来越痛苦,攻击者则继续钓鱼、撞库和窃取数据库。
复杂密码当然比 123456 更能抵抗猜测,但不管是:
123456
还是:
7#Qs9!Km2@Lp
都可以被完整复制。一旦攻击者拿到密码,他提交给系统的内容与真正用户完全相同。把密码从 12 位加到 16 位,能提高破解成本,却无法帮助系统区分“本人”和“拿到本人密码的人”。
当攻击手段从猜测扩展到偷窃、欺骗和复制时,只在密码复杂度上继续加码,收益就越来越有限了。
五、如果先假设密码会泄露呢?
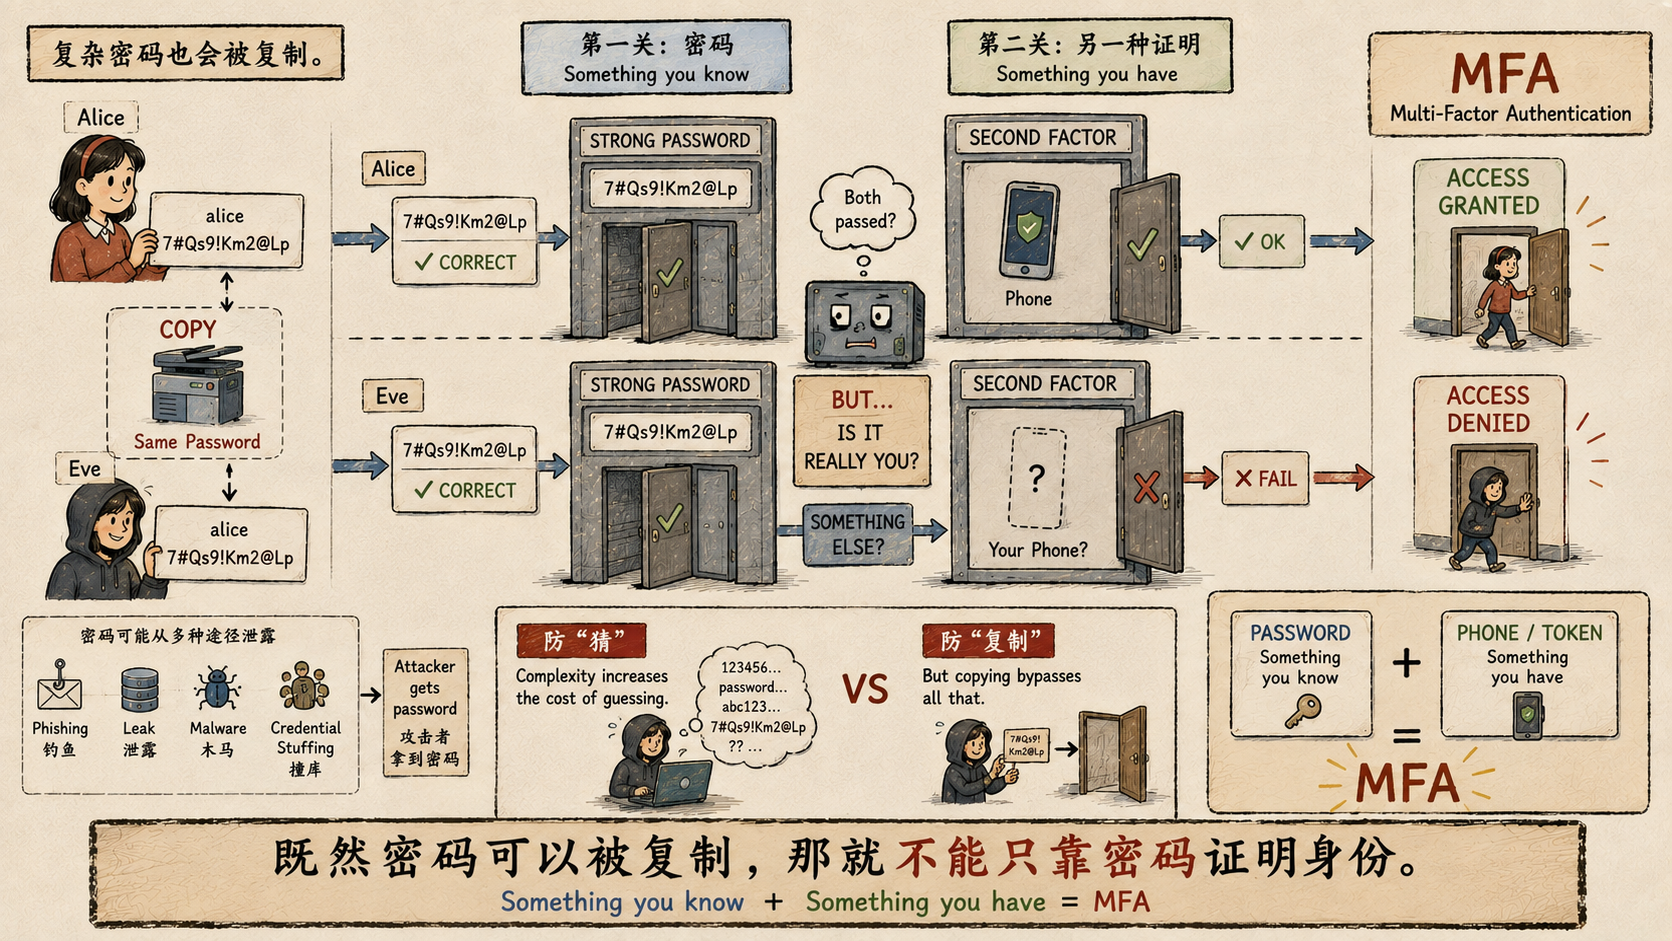
安全设计不能指望一道防线永远有效。与其假设密码绝不会泄露,不如直接考虑最坏的情况:攻击者已经拿到了 Alice 的密码,系统还能做什么?
再加一个密码看起来很合理:
密码 A + 密码 B
但两者都属于“你知道的东西”。钓鱼页面可以同时骗取它们,键盘记录程序也能一起记下。两个同类秘密,很可能在同一次攻击中同时失守。
更有效的办法,是增加一种性质不同的证明。例如:
密码 + 手机
或者:
密码 + 硬件令牌
攻击者即使知道密码,还得拿到 Alice 的手机或硬件令牌。认证不再只问“你知道什么”,还会问“你拥有什么”。
这正是多因子认证的核心。
六、两个步骤,不一定是两个因子
常见认证因子大致分为三类:
你知道的东西(Something you know)
密码、PIN

你拥有的东西(Something you have)
手机、智能卡、硬件令牌、安全密钥

你本身的特征(Something you are)
指纹、人脸等生物特征
NIST 对多因子认证的定义,重点也在于使用两个或更多不同类型的认证因子。因此,输两个密码不算真正的双因子;连续回答“你的小学老师叫什么”和“你母亲的姓氏是什么”也不算,因为它们仍然都是“你知道的东西”。
密码加手机、安全密钥加 PIN、设备加指纹,才是不同类型的组合。这样即使一种因子失守,攻击者仍需突破另一道性质不同的防线。
这里也顺便解释了一个常见误会:日常说的“两个验证码”,未必准确。密码是一种认证因子,短信验证码或身份验证器通常代表另一种因子。它们是两个验证步骤,但不一定都是“验证码”。
七、多出来的那一步,到底在防什么
现在再看常见的登录流程:
用户名 → 密码 → 手机验证码 → 登录成功
用户感受到的是“本来输一次,现在要输两次”。对系统来说,第二步是在处理一个更现实的前提:密码迟早可能失守。
这些年,人们为密码补过很多漏洞。明文传输容易被监听,就给通信加密;密码太容易猜,就提高长度和复杂度;数据库可能泄露,就使用加盐哈希保存;钓鱼和木马会直接偷走密码,就增加相应的检测和防护。
这些措施都有用,但没有哪一种能保证密码永远不会落到别人手里。MFA 因此不再把全部信任压在一个秘密上。系统在确认“你知道密码”之后,还要再看一项证据:你是否持有绑定的设备、安全密钥,或者能否提供本人的生物特征。
所以,多出来的验证并不是单纯给登录增加一道手续。它防的是密码已经泄露、系统却仍把持有密码的人当成本人的情况。
密码没有消失,只是不再被当作充分证据。这就是一个密码最后变成两步验证的原因。